ARC-AGI explicado: el test que mide la inteligencia de la IA
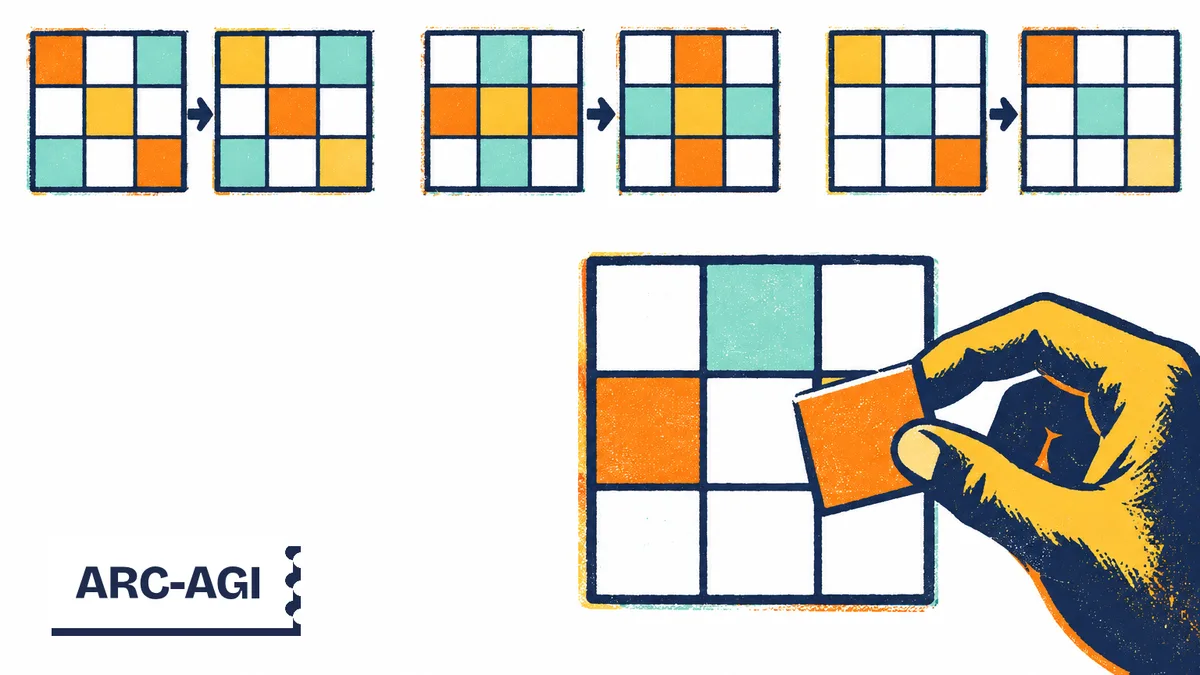
ARC-AGI es una familia de pruebas que evalúa cómo aprende una IA a resolver problemas nuevos con poca información. Sus primeras ediciones utilizan cuadrículas de colores; la edición interactiva también exige explorar un entorno y descubrir sus reglas. Este benchmark ofrece una medida concreta de la capacidad de adaptación, pero no basta para demostrar que existe una inteligencia artificial general.
Qué intenta medir ARC-AGI
Una IA puede superar una prueba porque durante su entrenamiento ha encontrado muchos problemas similares. El resultado demuestra una capacidad, pero por sí solo no indica cómo la ha adquirido. ARC-AGI busca que esa diferencia se pueda observar.
En On the Measure of Intelligence, publicado en noviembre de 2019, François Chollet propone definir la inteligencia a partir de la eficiencia con la que se adquieren capacidades. Su enfoque tiene en cuenta los conocimientos previos, la experiencia disponible y la dificultad de generalizar. Así, distingue el rendimiento final de la capacidad de aprender ante una situación desconocida.
La generalización consiste aquí en deducir una regla y aplicarla más allá de los ejemplos presentados. Una transformación aprendida con una disposición determinada debe seguir siendo válida cuando los objetos cambian de lugar, tamaño o color, siempre que esas variaciones respeten la lógica del problema.
ARC-AGI no exige aprender sin ningún punto de partida. Su diseño se apoya en conocimientos elementales explícitos, especialmente sobre los objetos, el espacio y las cantidades. El objetivo es reducir el peso de los conocimientos enciclopédicos para observar mejor cómo se aprende una regla propia de cada problema.
Esto también explica su alcance: explora una concepción particular de la inteligencia, en lugar de abarcar todas las capacidades humanas. Nuestro artículo sobre la medición de la inteligencia según François Chollet desarrolla esta distinción.
Cómo funcionan las cuadrículas de colores
En las ediciones con cuadrículas, usted observa ejemplos que relacionan una entrada con una salida. Después aparece una nueva entrada y debe construir la salida correspondiente. La instrucción general se mantiene; lo que cambia de una tarea a otra es la transformación que hay que descubrir.
El repositorio oficial de ARC-AGI-1 describe cuadrículas rectangulares representadas mediante números asociados a colores. También especifica que resolver una tarea implica producir las salidas esperadas con las dimensiones correctas. Para que una respuesta se considere correcta, todas las casillas deben coincidir exactamente.
Veamos un ejemplo didáctico inventado para explicar el principio, que no reproduce ninguna tarea oficial. Las demostraciones contienen figuras rellenas y figuras huecas. En todos los casos, la salida conserva únicamente las figuras huecas, sin desplazarlas.
Ante la nueva entrada, reconocer un color familiar no basta. Hay que identificar las figuras, determinar cuáles tienen el interior vacío y eliminar las demás, manteniendo las posiciones que correspondan.
Otra hipótesis podría ser conservar solo las figuras grandes. Parecería correcta si todas las figuras huecas de las demostraciones fueran también las de mayor tamaño. Un ejemplo adicional puede ayudar a decidir entre ambas explicaciones; sin él, hay que elegir la hipótesis mejor respaldada por lo observado.
El ejercicio evalúa tanto la elección de la regla como su ejecución. Una buena intuición seguida de una casilla incorrecta no produce una solución exacta. Del mismo modo, una salida correcta no revela automáticamente el método utilizado para obtenerla.
Por qué un problema visualmente sencillo puede resultar difícil
La sencillez del formato no garantiza que el razonamiento también sea sencillo. Una cuadrícula no indica necesariamente qué constituye un objeto, qué color representa el fondo o qué propiedad determina la transformación. Descubrir esos elementos forma parte del problema.
Volvamos al ejemplo didáctico. Antes de seleccionar las figuras huecas, el sistema debe decidir qué casillas forman parte de un mismo conjunto. Las figuras que se tocan pueden complicar esa separación, mientras que un cambio de escala puede invalidar una regla basada en dimensiones fijas.
La dificultad también surge al combinar operaciones. Identificar un objeto, atribuirle una propiedad, seleccionar una transformación y conservar determinadas relaciones espaciales son pasos distintos. Un error al principio puede hacer que toda la salida resulte incoherente.
Para analizar una tarea, puede plantearse estas preguntas por separado:
- ¿Qué elementos parecen mantenerse iguales entre la entrada y la salida?
- ¿Qué elementos cambian de forma sistemática?
- ¿Qué hipótesis explica todas las demostraciones disponibles?
- ¿Esa hipótesis exige excepciones sin justificación?
Estas preguntas ofrecen una forma de analizar el problema, pero no constituyen un algoritmo universal para resolverlo. Ayudan a entender por qué una explicación plausible no basta: la regla debe generar, en la práctica, la cuadrícula correcta.
Este análisis también permite distinguir varios tipos de fallo. El sistema puede interpretar mal los objetos, elegir una regla equivocada o ejecutar incorrectamente una regla adecuada. Un porcentaje global reúne todas esas dificultades sin permitir necesariamente diferenciarlas.
ARC-AGI-1, ARC-AGI-2 y ARC-AGI-3: pruebas diferentes
La denominación ARC-AGI abarca varias ediciones. La presentación oficial de ARC-AGI-1 sitúa su introducción en 2019. Esta primera edición establece el principio de deducir transformaciones desconocidas a partir de demostraciones.
Presentada en 2025, ARC-AGI-2 mantiene las cuadrículas, pero presta especial atención a la interpretación simbólica, la combinación de reglas y su aplicación según el contexto. Así, una marca puede desempeñar una función dentro de la tarea que va más allá de su apariencia.
ARC-AGI-3, disponible en 2026, incorpora entornos interactivos. El sistema debe actuar para obtener información, comprender los mecanismos y descubrir los objetivos. Ya no recibe simplemente todas las demostraciones antes de responder.
| Criterio | ARC-AGI-1 | ARC-AGI-2 | ARC-AGI-3 |
|---|---|---|---|
| Formato | Cuadrículas estáticas | Cuadrículas estáticas | Entornos interactivos |
| Información inicial | Ejemplos de entradas y salidas | Ejemplos de entradas y salidas | Observaciones obtenidas mediante interacciones |
| Trabajo requerido | Deducir una transformación | Deducir reglas y sus interacciones | Explorar, aprender y planificar |
| Resultado observado | Salidas exactas | Salidas exactas, con atención a la eficiencia | Éxito y eficiencia de las acciones |
Por tanto, estas ediciones no forman una escala cuyos resultados se puedan intercambiar. Un mismo porcentaje puede corresponder a tareas y criterios diferentes.
También hay que distinguir el benchmark del ARC Prize: el primero define una evaluación; el segundo organiza competiciones y establece sus condiciones de participación. Nuestra página de referencia sobre ARC-AGI reúne las ediciones y los protocolos que conviene consultar antes de comparar resultados.
Con la interacción, aprender también implica elegir cómo actuar
Cuando una demostración se proporciona de antemano, el participante no tiene que decidir cómo obtener la información. En un entorno interactivo, esa decisión pasa a ser fundamental. Una acción puede acercar al objetivo, pero también servir para comprender una regla todavía desconocida.
Imagine un entorno didáctico en el que un movimiento revela que una zona impide el paso. El sistema debe incorporar esa observación y modificar su recorrido. Repetir el mismo movimiento sin aprovechar la información recibida indica una dificultad de adaptación, aunque una larga sucesión de intentos termine dando resultado.
El informe científico de ARC-AGI-3, revisado en abril de 2026, describe una evaluación basada en entornos abstractos, objetivos que hay que deducir y una eficiencia medida en número de acciones respecto a referencias humanas. Por tanto, también cuenta el recorrido seguido para llegar al estado final.
Esta dimensión acerca la prueba a las preguntas que afrontan los agentes: qué observar, qué acción probar, cuándo revisar una hipótesis y cómo conservar la información útil. Sin embargo, eso no convierte un juego abstracto en una simulación completa de una actividad profesional.
Un entorno controlado permite aislar determinadas capacidades. Una tarea real añade otras restricciones: documentos ambiguos, herramientas no disponibles, permisos o consecuencias de un error. La sección dedicada a la AGI y la investigación sitúa estas medidas dentro de un conjunto más amplio de enfoques sobre la inteligencia.
Cómo interpretar una puntuación sin atribuirle más de lo que mide
Una puntuación describe un sistema evaluado con un protocolo concreto. Hay que conocer la edición, las tareas utilizadas, las opciones de respuesta y los recursos disponibles. El nombre de un modelo no resume todas esas condiciones.
La página oficial de resultados, consultada el 24 de octubre de 2026, muestra, por ejemplo, para GPT-6.1 Sol una fila fechada el 29 de septiembre de 2026: 98,5 % en ARC-AGI-1, 94,2 % en ARC-AGI-2 y 96,37 % en ARC-AGI-3. Estos valores corresponden a evaluaciones distintas; que las cifras sean próximas no significa que sean equivalentes.
Este ejemplo recuerda por qué un resultado histórico debe conservar su fecha. Los datos recogidos en el lanzamiento de una edición no describen necesariamente el nivel de rendimiento varios meses después.
Antes de citar un resultado, compruebe:
- El conjunto evaluado: tareas públicas, semiprivadas o privadas.
- La configuración: instrucciones, herramientas y procesamiento de las respuestas.
- Los intentos permitidos: una respuesta única y varias propuestas no constituyen la misma prueba.
- Los recursos: capacidad de cómputo, presupuesto y tiempo disponibles.
- La procedencia: medición oficial, reproducción independiente o resultado declarado.
Los conjuntos públicos facilitan la experimentación, pero reutilizarlos durante el desarrollo complica la interpretación de las mejoras. La contaminación de los benchmarks se refiere a la exposición a los datos de evaluación; una puntuación alta no demuestra por sí sola que haya ocurrido.
Para profundizar en esta cuestión, el artículo Cómo interpretar las clasificaciones de modelos detalla la información que debería acompañar a una tabla de resultados.
Por qué importan el cómputo y el sistema completo
Una solución puede requerir algo más que generar una respuesta directamente: varias hipótesis, un programa de transformación, comprobaciones o una selección entre posibles respuestas. Por eso hay que distinguir el modelo utilizado del conjunto del sistema que realiza la prueba.
El repositorio oficial de evaluación de modelos ilustra esta parte experimental: ejecutar un benchmark requiere código, configuraciones y un procedimiento de medición. Para reproducir un resultado, no basta con conocer al proveedor del modelo.
Considere dos configuraciones hipotéticas. Una encuentra rápidamente una regla correcta; la otra explora muchas posibilidades antes de llegar a la solución. El éxito final puede parecer idéntico, pero el costo y la utilidad de ambas configuraciones cambian cuando existe un límite de tiempo.
Esto no invalida el uso de más recursos de cómputo. Lo necesario es hacer visible ese uso. Una mejora puede deberse a un método más eficaz, a recursos adicionales o a una combinación de ambos; el porcentaje por sí solo no permite determinarlo.
El costo económico también exige una interpretación cuidadosa. Depende de las tarifas y de la infraestructura, mientras que el tiempo transcurrido depende, entre otros factores, del procesamiento en paralelo. Estas medidas ayudan a valorar la eficiencia desde distintos ángulos, pero no sustituyen el análisis del método.
Para su propia evaluación, establezca las restricciones antes de medir. De lo contrario, corre el riesgo de comparar una configuración limitada con un sistema que dispone de muchos más intentos.
Superar ARC-AGI no equivale a obtener una certificación de AGI
Una evaluación puede ser exigente y, aun así, tener un alcance parcial. ARC-AGI no abarca por sí solo la comprensión social, el conjunto de los conocimientos científicos, la fiabilidad en aplicaciones empresariales o el comportamiento ante solicitudes contradictorias.
Su diseño también incorpora decisiones: los tipos de problemas seleccionados, los conocimientos previos que se presuponen, la interfaz y los criterios de éxito. Estas decisiones hacen posible la evaluación, pero también delimitan lo que se puede afirmar a partir de sus resultados.
La referencia humana merece la misma cautela. Demostrar que las personas pueden resolver una tarea no significa que cualquier persona vaya a hacerlo de inmediato. Una comparación debe precisar quiénes participan, cuántos intentos tienen y qué recursos utilizan, en lugar de enfrentar de forma abstracta una máquina a toda la humanidad.
Por tanto, una puntuación alta aporta información sobre las capacidades evaluadas. No ofrece una medida exhaustiva de la inteligencia ni fija automáticamente una fecha de llegada de la AGI. Del mismo modo, fallar en las cuadrículas no anula todas las capacidades prácticas de un sistema.
Para elegir una herramienta profesional, parta de sus tareas: la calidad esperada, los errores aceptables, el costo y el control necesario. La guía Evaluar un agente de IA explica cómo construir esa evaluación complementaria. ARC-AGI sirve entonces como indicador de investigación que debe contrastarse con los resultados obtenidos en su propio contexto.
Puntos clave
- ARC-AGI estudia el aprendizaje de reglas nuevas con poca información, dentro de un ámbito definido.
- Las ediciones con cuadrículas y la edición interactiva evalúan comportamientos diferentes.
- Una puntuación debe conservar su fecha, su protocolo, su conjunto de tareas y sus condiciones de cómputo.
- Superar la prueba aporta evidencia sobre capacidades concretas, pero no certifica por sí solo una inteligencia artificial general.
Preguntas frecuentes
¿Qué significa ARC-AGI?
ARC corresponde a Abstraction and Reasoning Corpus. La denominación ARC-AGI vincula este conjunto de problemas con la evaluación de la inteligencia artificial general, pero superarlo no equivale a obtener una certificación de AGI.
¿Se puede probar ARC-AGI sin saber programar?
Sí. Las interfaces disponibles desde las páginas oficiales permiten resolver las cuadrículas manualmente o jugar en los entornos interactivos. Para crear un sistema que realice las evaluaciones de forma automática, sí es necesario programar.
¿ARC-AGI es un test de cociente intelectual para la IA?
La comparación ayuda a entender la idea de enfrentarse a problemas desconocidos, pero no va más allá. Un porcentaje en ARC-AGI no se puede convertir en un cociente intelectual humano: las tareas, las condiciones de aprendizaje y los recursos disponibles son diferentes.
¿Por qué cambian los resultados de ARC-AGI de una publicación a otra?
Las publicaciones pueden utilizar ediciones, conjuntos de tareas o configuraciones diferentes. También influyen los recursos de cómputo y el número de respuestas permitidas. Para comparar resultados, hace falta conocer más que el nombre del modelo y su porcentaje.