ARC-AGI expliqué : le test qui mesure l'intelligence des IA
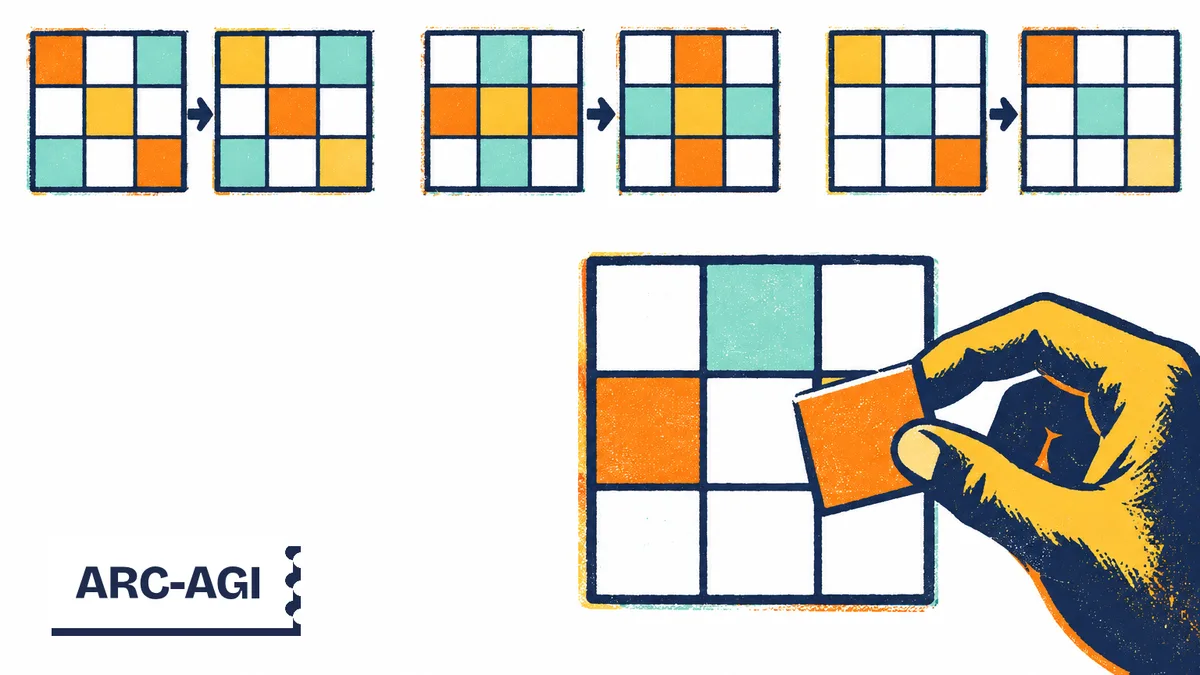
ARC-AGI est une famille de tests qui évalue comment une IA apprend à résoudre des problèmes nouveaux à partir de peu d’informations. Ses premières éditions utilisent des grilles colorées ; l’édition interactive demande aussi d’explorer un environnement et d’en découvrir les règles. Le benchmark apporte une mesure ciblée de l’adaptation, mais ne suffit pas à établir qu’une intelligence artificielle générale existe.
Ce qu’ARC-AGI cherche à mesurer
Une IA peut réussir une épreuve parce qu’elle a rencontré beaucoup de problèmes similaires pendant son entraînement. Le résultat démontre une compétence, sans indiquer à lui seul comment cette compétence a été acquise. ARC-AGI cherche à rendre cette distinction observable.
Dans On the Measure of Intelligence, publié en novembre 2019, François Chollet propose de définir l’intelligence par l’efficacité d’acquisition de compétences. Son approche tient compte des connaissances préalables, de l’expérience disponible et de la difficulté de généralisation. Elle distingue donc la performance finale de la capacité à apprendre face à une situation inconnue.
La généralisation consiste ici à dégager une règle puis à l’appliquer au-delà des exemples montrés. Une transformation apprise sur une disposition donnée doit rester pertinente quand les objets changent de place, de taille ou de couleur, si ces variations respectent la logique du problème.
ARC-AGI ne demande pas d’apprendre sans aucun point de départ. Sa conception repose sur des connaissances élémentaires explicites, notamment relatives aux objets, à l’espace et aux quantités. L’ambition est de réduire le rôle du savoir encyclopédique pour mieux observer l’apprentissage d’une règle locale.
Cela explique aussi son périmètre : il explore une conception particulière de l’intelligence, plutôt qu’un inventaire de toutes les capacités humaines. Notre article sur la mesure de l’intelligence selon François Chollet développe cette distinction.
Comment fonctionnent les grilles colorées
Dans les éditions à grilles, vous observez des exemples associant une entrée à une sortie. Une nouvelle entrée apparaît ensuite, et vous devez construire la sortie correspondante. La consigne générale reste stable ; la transformation à découvrir change d’une tâche à l’autre.
Le dépôt officiel d’ARC-AGI-1 décrit des grilles rectangulaires représentées par des nombres associés à des couleurs. Il précise que résoudre une tâche implique de produire les sorties attendues, avec leurs bonnes dimensions. La correction exige une correspondance exacte des cases.
Voici un exemple pédagogique inventé pour expliquer le principe, qui ne reproduit aucune tâche officielle. Les démonstrations montrent des formes pleines et des formes creuses. À chaque fois, la sortie conserve uniquement les formes creuses, sans les déplacer.
Sur la nouvelle entrée, reconnaître une couleur familière ne suffit pas. Il faut identifier les formes, déterminer lesquelles possèdent un intérieur vide, puis supprimer les autres en préservant les positions utiles.
Une hypothèse concurrente pourrait être de conserver seulement les grandes formes. Elle semblerait correcte si toutes les formes creuses des démonstrations étaient aussi les plus grandes. Un exemple supplémentaire peut départager ces explications ; sans lui, il faut choisir l’hypothèse la mieux justifiée par les observations.
L’exercice porte ainsi sur le choix de la règle autant que sur son exécution. Une bonne intuition suivie d’une case erronée ne donne pas une solution exacte. Inversement, une sortie correcte ne révèle pas automatiquement la méthode employée pour l’obtenir.
Pourquoi un problème visuellement simple peut être difficile
La simplicité du support ne garantit pas celle du raisonnement. Une grille ne précise pas nécessairement ce qui constitue un objet, quelle couleur représente le fond ou quelle propriété commande la transformation. Ces éléments font partie du problème à résoudre.
Reprenons l’exemple pédagogique. Avant de sélectionner les formes creuses, un système doit décider quelles cases appartiennent ensemble. Des formes qui se touchent peuvent compliquer cette segmentation, tandis qu’un changement d’échelle peut rendre inutilisable une règle fondée sur des dimensions fixes.
La difficulté vient aussi de la combinaison des opérations. Repérer un objet, lui attribuer une propriété, sélectionner une transformation et préserver certaines relations spatiales sont des étapes distinctes. Une erreur au début peut rendre incohérente toute la sortie.
Pour analyser une tâche, vous pouvez séparer ces questions :
- Quels éléments semblent rester identiques entre l’entrée et la sortie ?
- Quels éléments changent systématiquement ?
- Quelle hypothèse explique toutes les démonstrations disponibles ?
- Cette hypothèse impose-t-elle des exceptions sans justification ?
Ces questions constituent une méthode de lecture, pas un algorithme universel de résolution. Elles montrent pourquoi une description plausible ne suffit pas : la règle doit produire concrètement la bonne grille.
Ce type d’analyse aide également à distinguer plusieurs échecs. Le système peut mal percevoir les objets, sélectionner une mauvaise règle ou exécuter incorrectement une règle pertinente. Un pourcentage global rassemble ces difficultés sans forcément permettre de les départager.
ARC-AGI-1, ARC-AGI-2 et ARC-AGI-3 : des épreuves distinctes
L’appellation ARC-AGI recouvre plusieurs éditions. La présentation officielle d’ARC-AGI-1 situe son introduction en 2019. La première édition établit le principe des transformations inconnues à déduire à partir de démonstrations.
Présentée en 2025, ARC-AGI-2 conserve les grilles, mais insiste notamment sur l’interprétation symbolique, la combinaison de règles et leur application selon le contexte. Une marque peut ainsi avoir une fonction dans la tâche, au-delà de son apparence.
ARC-AGI-3, disponible en 2026, introduit des environnements interactifs. Le système doit agir pour obtenir des informations, comprendre les mécanismes et découvrir les objectifs. Il ne reçoit plus simplement toutes les démonstrations avant de répondre.
| Critère | ARC-AGI-1 | ARC-AGI-2 | ARC-AGI-3 |
|---|---|---|---|
| Support | Grilles statiques | Grilles statiques | Environnements interactifs |
| Informations initiales | Exemples d’entrées et de sorties | Exemples d’entrées et de sorties | Observations issues des interactions |
| Travail demandé | Déduire une transformation | Déduire des règles et leurs interactions | Explorer, apprendre et planifier |
| Résultat observé | Sorties exactes | Sorties exactes, avec attention à l’efficacité | Réussite et efficacité des actions |
Ces éditions ne forment donc pas une échelle interchangeable. Un même pourcentage peut désigner des tâches et des critères différents.
Il faut aussi distinguer le benchmark de l’ARC Prize : le premier définit une évaluation ; le second organise des compétitions et leurs conditions de participation. Notre page de référence ARC-AGI rassemble les éditions et les protocoles à consulter avant toute comparaison.
Avec l’interaction, apprendre devient aussi choisir ses actions
Une démonstration donnée à l’avance évite au candidat de décider comment recueillir l’information. Dans un environnement interactif, ce choix devient central. Une action peut faire progresser vers le but, mais aussi servir à comprendre une règle encore inconnue.
Imaginez un environnement pédagogique où un déplacement révèle qu’une zone bloque le passage. Le système doit intégrer cette observation et modifier son parcours. Répéter le même déplacement sans exploiter le retour reçu indique une difficulté d’adaptation, même si une longue succession d’essais finit par réussir.
Le rapport scientifique d’ARC-AGI-3, révisé en avril 2026, décrit une évaluation fondée sur des environnements abstraits, des objectifs à inférer et une efficacité mesurée par rapport à des références humaines en nombre d’actions. Le parcours compte donc, au-delà de l’état final atteint.
Cette dimension rapproche l’épreuve des questions posées par les agents : quoi observer, quelle action tenter, quand réviser une hypothèse et comment conserver les informations utiles. Elle ne transforme cependant pas un jeu abstrait en simulation complète d’un travail professionnel.
Un environnement contrôlé permet d’isoler certaines capacités. Une tâche réelle ajoute d’autres contraintes : documents ambigus, outils indisponibles, permissions ou conséquences d’une erreur. La rubrique consacrée à l’AGI et à la recherche replace ces mesures dans un ensemble plus large d’approches de l’intelligence.
Comment lire un score sans lui faire dire davantage
Un score décrit un système dans un protocole donné. Il faut connaître l’édition, les tâches utilisées, les possibilités de réponse et les ressources disponibles. Le nom d’un modèle ne résume pas ces conditions.
La page officielle des résultats, consultée le 24 octobre 2026, affiche par exemple pour GPT-6.1 Sol une ligne datée du 29 septembre 2026 : 98,5 % sur ARC-AGI-1, 94,2 % sur ARC-AGI-2 et 96,37 % sur ARC-AGI-3. Ces valeurs appartiennent à des évaluations distinctes ; leur proximité numérique ne les rend pas équivalentes.
Cet exemple rappelle pourquoi un résultat historique doit conserver sa date. Une photographie prise au lancement d’une édition ne décrit pas nécessairement l’état des performances plusieurs mois plus tard.
Avant de reprendre un résultat, vérifiez :
- L’ensemble évalué : tâches publiques, semi-privées ou privées.
- La configuration : instructions, outils et traitement des réponses.
- Les essais autorisés : une réponse unique et plusieurs propositions ne constituent pas la même épreuve.
- Les ressources : calcul, coût et délai disponibles.
- La provenance : mesure officielle, reproduction indépendante ou résultat déclaré.
Les ensembles publics facilitent l’expérimentation, mais leur réutilisation pendant le développement complique l’interprétation d’un progrès. La contamination des benchmarks concerne l’exposition aux données d’évaluation ; elle ne se déduit pas d’un score élevé.
Pour approfondir cette lecture, l’article Comprendre les classements des modèles détaille les informations qu’un tableau de résultats devrait accompagner.
Pourquoi le calcul et le système complet comptent
Une solution peut mobiliser davantage que la production directe d’une réponse : plusieurs hypothèses, un programme de transformation, des vérifications ou une sélection entre candidats. Il faut donc distinguer le modèle utilisé de l’ensemble du dispositif qui passe l’épreuve.
Le dépôt officiel d’évaluation des modèles illustre cette couche expérimentale : le passage d’un benchmark demande du code, des configurations et une procédure de mesure. Pour reproduire un résultat, connaître uniquement le fournisseur du modèle reste insuffisant.
Considérez deux configurations hypothétiques. L’une trouve rapidement une règle correcte ; l’autre explore beaucoup de possibilités avant d’aboutir. Leur réussite finale peut sembler identique, mais elles n’ont pas le même coût ni la même utilité sous une contrainte de délai.
Cela ne rend pas le calcul supplémentaire illégitime. Il faut simplement le rendre visible. Une amélioration peut venir d’une meilleure méthode, de ressources supplémentaires ou de leur combinaison ; le pourcentage seul ne permet pas de trancher.
Le coût monétaire demande lui aussi une lecture prudente. Il dépend des tarifs et de l’infrastructure, tandis que le temps écoulé dépend notamment du parallélisme. Ces mesures éclairent l’efficacité sous différents angles sans remplacer l’examen de la méthode.
Pour votre propre évaluation, fixez les contraintes avant de mesurer. Sinon, vous risquez de comparer une configuration limitée à un système disposant de beaucoup plus de tentatives.
Réussir ARC-AGI ne constitue pas une certification d’AGI
Une évaluation peut être exigeante tout en restant partielle. ARC-AGI ne couvre pas à lui seul la compréhension sociale, l’ensemble des connaissances scientifiques, la fiabilité dans les logiciels métier ou le comportement face à des demandes contradictoires.
Sa conception comporte aussi des choix : types de problèmes retenus, connaissances préalables supposées, interface et critères de réussite. Ces choix rendent l’évaluation possible, mais délimitent ce que ses résultats autorisent à affirmer.
La référence humaine mérite la même prudence. Montrer qu’une tâche est résoluble par des personnes ne signifie pas que toute personne la réussira immédiatement. Une comparaison doit préciser les participants, les essais et les ressources, plutôt que d’opposer abstraitement une machine à l’humanité entière.
Un score élevé apporte donc une information sur les capacités évaluées. Il ne fournit ni une mesure exhaustive de l’intelligence ni une date automatique d’arrivée de l’AGI. Inversement, un échec sur des grilles n’annule pas toutes les compétences pratiques d’un système.
Pour choisir un outil professionnel, partez de vos tâches : qualité attendue, erreurs acceptables, coût et contrôle nécessaire. Le guide Évaluer un agent IA explique comment construire cette mesure complémentaire. ARC-AGI sert alors de signal de recherche, à confronter aux résultats obtenus dans votre contexte.
À retenir
- ARC-AGI étudie l’apprentissage de règles nouvelles avec peu d’informations, dans un périmètre défini.
- Les éditions à grilles et l’édition interactive évaluent des comportements différents.
- Un score doit conserver sa date, son protocole, son ensemble de tâches et ses conditions de calcul.
- La réussite apporte une preuve ciblée de capacité, sans certifier à elle seule une intelligence artificielle générale.
Questions fréquentes
Que signifie ARC-AGI ?
ARC désigne l'Abstraction and Reasoning Corpus. L'appellation ARC-AGI rattache ce corpus à l'évaluation de l'intelligence artificielle générale, sans faire de sa réussite une certification d'AGI.
Peut-on essayer ARC-AGI sans savoir programmer ?
Oui. Les interfaces accessibles depuis les pages officielles permettent de résoudre manuellement les grilles ou de jouer aux environnements interactifs. Programmer devient nécessaire pour construire un système qui passe automatiquement les évaluations.
ARC-AGI est-il un test de QI pour les IA ?
L'analogie aide à comprendre l'idée de problèmes inconnus, mais elle s'arrête là. Un pourcentage ARC-AGI ne se convertit pas en QI humain : les tâches, les conditions d'apprentissage et les ressources disponibles diffèrent.
Pourquoi les scores ARC-AGI changent-ils selon les publications ?
Les publications peuvent utiliser des éditions, des ensembles de tâches ou des configurations différents. Le budget de calcul et le nombre de réponses autorisées comptent aussi. Une comparaison exige donc davantage que le nom du modèle et son pourcentage.