

Serveur MCP : définition et les meilleurs serveurs à connaître
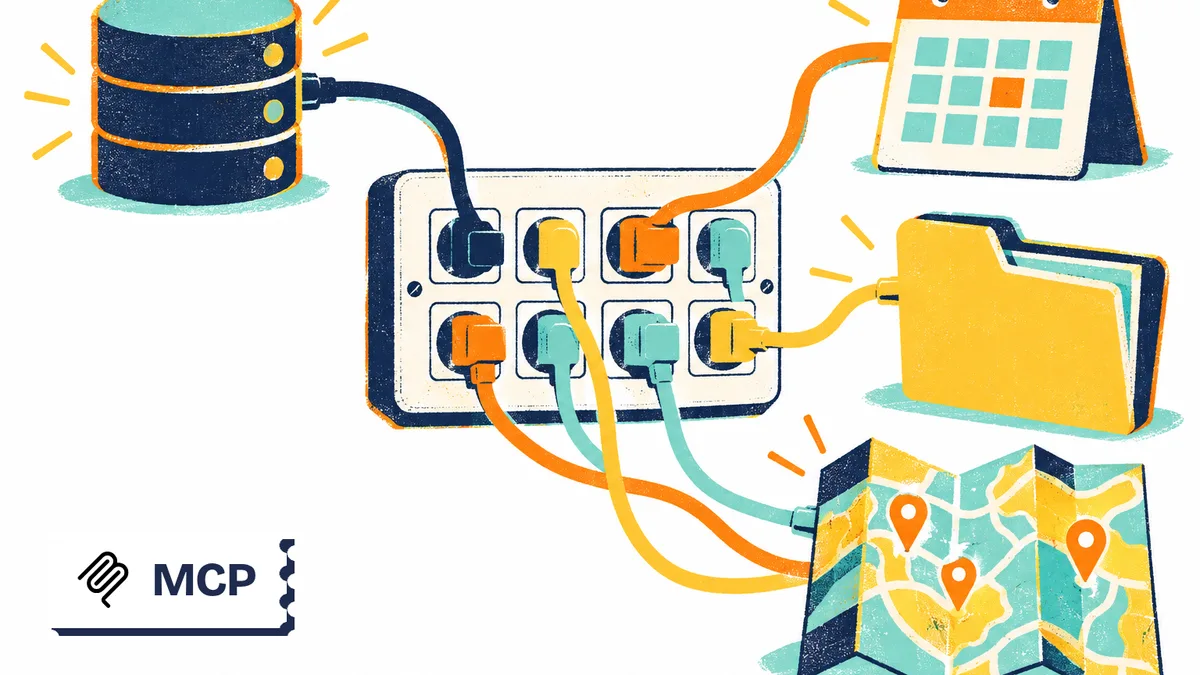
Un serveur MCP est un programme qui permet à un assistant IA d’accéder à des outils et à des données par une interface standard. Il peut exposer des fichiers, consulter un dépôt de code, rechercher une documentation ou piloter un navigateur. Pour commencer, choisissez un serveur lié à une tâche précise, puis limitez ses accès avant de le connecter.
Comment fonctionne un serveur MCP
Le protocole MCP, pour Model Context Protocol, organise les échanges entre une application d’IA et des programmes externes. L’application hôte contient un client MCP qui communique avec le serveur. Celui-ci donne accès aux fonctions ou aux informations qu’il expose.
La documentation officielle de l’architecture distingue notamment les outils exécutables, les ressources de contexte et les modèles d’instructions réutilisables. Un serveur peut proposer certaines de ces capacités sans toutes les prendre en charge.
Prenons un exemple hypothétique : vous demandez de résumer les tickets ouverts d’un projet. L’assistant utilise un outil de consultation, reçoit les tickets puis rédige une synthèse. S’il dispose aussi d’une fonction de modification, il peut proposer de changer leur statut : cette permission supplémentaire mérite un contrôle distinct.
Le serveur fournit les capacités ; l’application et le modèle organisent leur utilisation. MCP ne garantit ni la pertinence du résumé, ni la justesse de l’action choisie. Un résultat doit toujours être vérifiable dans le système d’origine.
Cette séparation aide à diagnostiquer les erreurs. Une connexion refusée relève souvent de la configuration ou de l’authentification ; une synthèse inexacte peut venir du modèle, de la demande ou des données retournées. Réinstaller le serveur ne résout pas nécessairement le second problème.
Serveur local ou distant : ce que cela change
Un serveur MCP peut fonctionner sur votre ordinateur ou chez un fournisseur. Le choix dépend des données à atteindre, des possibilités de votre application et de la maintenance que vous acceptez.
| Critère | Serveur local | Serveur distant |
|---|---|---|
| Exécution | Programme lancé sur votre machine | Service accessible par le réseau |
| Connexion habituelle | Entrée et sortie standard, dites stdio | Transport réseau, notamment Streamable HTTP |
| Accès à examiner | Fichiers, processus et réseau de la machine | Comptes connectés et données transmises |
| Maintenance | Installation et mises à jour à organiser | Service entretenu par son opérateur |
| Point de vigilance | Droits du programme exécuté | Identité de l’opérateur et autorisations accordées |
Local ne signifie pas confidentiel. Avant une installation locale, vérifiez si le programme appelle une API externe. Examinez aussi ce que l’application d’IA transmet au modèle : le chemin complet des données compte davantage que l’emplacement d’un composant.
Inversement, une connexion distante évite parfois d’entretenir un programme, mais ajoute un opérateur dans le circuit. Identifiez les données envoyées, les modalités de révocation et les fonctions réellement accessibles.
Pour choisir, partez du besoin : lire un dossier de travail, consulter une documentation publique ou agir sur un compte professionnel ne demande pas le même périmètre. Le guide pour choisir un serveur MCP développe cette évaluation.
Quels serveurs MCP connaître en priorité
La sélection suivante couvre des besoins différents. Elle ne constitue pas un classement de performances : un serveur de documentation et un serveur de navigateur ne rendent pas le même service.
Les critères retenus sont l’existence d’une source officielle identifiable, une fonction compréhensible et la possibilité de définir un périmètre d’essai. Les fiches de l’annuaire des serveurs MCP permettent d’élargir la recherche.
| Serveur | Besoin principal | Connexion à examiner | Limite à anticiper |
|---|---|---|---|
| Context7 | Consulter la documentation de bibliothèques | Service documentaire distant | Couverture et version du contenu |
| GitHub MCP Server | Travailler sur des dépôts et tickets | Serveur officiel distant ou local | Droits de lecture et de modification |
| Playwright MCP | Piloter un navigateur | Environnement de navigation | Sessions et actions accessibles |
| Firecrawl MCP Server | Rechercher et extraire du contenu web | Service hébergé ou connexion configurée | Quotas, couverture et volume collecté |
| Filesystem | Manipuler des fichiers | Programme local et dossiers autorisés | Écriture et accès trop larges |
| MCP Toolbox for Databases | Connecter des bases de données | Serveur relié aux sources configurées | Requêtes et privilèges du compte |
Avant d’installer, demandez-vous également si votre assistant possède déjà la fonction nécessaire. Ajouter une connexion uniquement pour reproduire un accès existant augmente le travail de configuration sans bénéfice établi. Le bon point de départ reste une tâche observable que vous ne pouvez pas réaliser correctement avec les fonctions disponibles.
Documentation et dépôts : Context7 et GitHub
Context7 pour retrouver les bonnes références
Selon son dépôt officiel, Context7 fournit aux agents de code de la documentation et des exemples associés aux bibliothèques et à leurs versions. Le projet propose un mode MCP, ainsi qu’une autre voie fondée sur une interface en ligne de commande et des skills.
Son usage pertinent : demander une référence documentaire avant de modifier une intégration. Précisez la bibliothèque et la version utilisée dans votre projet, puis contrôlez que les passages récupérés correspondent à ce contexte.
Cela reste une source à examiner. Une documentation retrouvée ne prouve pas que le code généré fonctionne dans votre application. Vérifiez les prérequis et exécutez les contrôles adaptés à la modification.
GitHub MCP Server pour les dépôts et tickets
Le serveur officiel de GitHub permet notamment de consulter du code, de gérer des tickets et des demandes de fusion. Il propose un service distant et une exécution locale, ainsi que des réglages pour restreindre les fonctions exposées.
Pour un premier usage, limitez-vous à la lecture d’un dépôt choisi. Une tâche possible consiste à retrouver les fichiers concernés par un ticket, avec des liens permettant de contrôler la réponse.
Le mode lecture seule du serveur retire les outils de modification. Associez-le à des identifiants eux-mêmes limités : masquer un outil et réduire les droits du compte sont deux contrôles complémentaires. N’accordez l’écriture que lorsqu’une tâche la justifie.
Navigation et recherche web : Playwright et Firecrawl
Playwright MCP pour interagir avec une page
Playwright MCP expose des fonctions d’automatisation du navigateur et s’appuie notamment sur sa représentation d’accessibilité. Il convient aux tâches qui nécessitent de parcourir une interface et d’interagir avec ses éléments.
Un premier essai peut consister à ouvrir une application de démonstration et à relever les champs d’un formulaire. Utilisez une session distincte de votre navigation quotidienne et évitez les comptes disposant de droits étendus.
La réussite d’un clic ne suffit pas à valider une tâche. Contrôlez l’état final dans l’application : un formulaire rempli, une recherche effectuée et une opération enregistrée sont des résultats différents.
Firecrawl MCP Server pour collecter du contenu
Le serveur officiel de Firecrawl expose notamment des fonctions de recherche, d’extraction et d’exploration web. Les capacités accessibles dépendent de la connexion et des autorisations configurées.
Il peut servir à récupérer des pages à analyser, avec leurs adresses d’origine. Pour une veille, demandez une collecte limitée à des sources identifiées et conservez les liens pour vérifier chaque information.
Avant une collecte étendue, contrôlez les quotas et les conditions du service. Demandez seulement les contenus utiles : accumuler des pages sans critère de sélection augmente la quantité de données à examiner. Une extraction réussie ne garantit ni l’exhaustivité ni l’actualité des informations présentes sur le site consulté.
Fichiers et bases de données : encadrer les accès
Filesystem pour un dossier de travail limité
Filesystem fournit des opérations sur les fichiers avec un contrôle des répertoires accessibles. Son dépôt de référence MCP précise que les serveurs qu’il contient sont des exemples destinés aux développeurs, et non des solutions prêtes pour la production sans évaluation supplémentaire.
Pour découvrir son fonctionnement, préparez un dossier contenant des copies de documents sans données sensibles. Commencez par demander un inventaire, puis un résumé dont vous pouvez vérifier les sources.
N’autorisez pas tout votre répertoire personnel par commodité. Définissez les dossiers nécessaires et examinez les opérations disponibles, notamment l’écriture. Si votre assistant sait déjà manipuler les fichiers du projet, vérifiez ce que cette connexion apporte avant de l’ajouter.
MCP Toolbox for Databases pour des requêtes cadrées
MCP Toolbox for Databases connecte des applications d’IA à des bases de données et permet de définir des outils spécialisés. Le projet s’appelait auparavant Gen AI Toolbox for Databases ; son dépôt a également été renommé de genai-toolbox à mcp-toolbox.
Une utilisation à envisager consiste à exposer une requête métier précise, avec des paramètres contrôlés, plutôt qu’un accès général à toutes les tables.
Pour l’essai, utilisez une base de démonstration et un compte limité. Vérifiez la requête exécutée, les colonnes retournées et le volume de résultats. Une restriction décrite dans les instructions de l’assistant ne remplace pas les permissions effectivement appliquées par la base.
Préparer une première connexion vérifiable
Prérequis : une application compatible avec le serveur choisi, les autorisations nécessaires sur la source et un environnement d’essai. Pour un programme local, ajoutez les dépendances indiquées dans sa documentation officielle. Leur présence doit être vérifiée avant de chercher une erreur dans MCP.
La procédure précise dépend du client. Le tutoriel Installer un serveur MCP détaille cette partie ; voici une méthode de préparation commune.
- Définissez le résultat attendu. Par exemple, retrouver un document connu ou lister les tickets d’un dépôt de démonstration.
- Identifiez la source officielle. Vérifiez le propriétaire du dépôt, le paquet distribué et l’adresse du service.
- Choisissez le périmètre minimal. Limitez dossiers, dépôts, tables et opérations avant de connecter le compte.
- Suivez la configuration du client. Utilisez les champs et le transport indiqués pour cette application.
- Contrôlez le résultat et le refus. Vérifiez l’accès autorisé, puis qu’une demande hors périmètre échoue.
Évitez de recopier une configuration trouvée dans une discussion ancienne. Les noms de paquets, les adresses et les modes d’authentification peuvent évoluer ; vérifiez-les dans la documentation au moment de l’installation.
Conservez une note avec l’origine du serveur, les permissions accordées et la méthode de désactivation. Ce relevé facilite une mise à jour, un changement de poste ou le retrait d’une connexion devenue inutile.
Coût réel et permissions à surveiller
Le coût dépend de plusieurs éléments : abonnement de l’assistant, consommation du modèle, service appelé et éventuel hébergement. Un programme disponible sans frais de licence peut nécessiter une API facturée. Une connexion réussie ne permet donc pas de conclure que l’usage est gratuit.
Pour établir un budget, mesurez une tâche représentative : appels effectués, quantité de contenu retournée, durée et reprises nécessaires. Comparez ensuite ces observations aux conditions des fournisseurs concernés. Évitez d’extrapoler à partir d’une démonstration qui ne ressemble pas à votre travail.
La sécurité dépend aussi des combinaisons d’accès. Un assistant qui lit des contenus externes et peut écrire ailleurs doit traiter ces contenus comme des données. Une injection de prompt peut tenter de transformer une page ou un ticket en ordre d’action.
Les bonnes pratiques de sécurité du protocole, publiées dans la documentation en cours d’élaboration, décrivent notamment les risques liés aux autorisations, aux jetons et à l’exécution locale. Elles ne constituent pas une certification des serveurs.
En pratique, séparez les comptes d’essai, limitez les secrets accessibles et exigez une validation pour les actions sensibles. Consultez aussi l’article MCP et skills malveillants : vérifier avant d’installer avant d’ajouter une extension inconnue.
Problèmes fréquents et vérification finale
Le serveur reste invisible. Vérifiez que la configuration est enregistrée dans le bon client et que celui-ci prend en charge le transport choisi. Pour un programme local, consultez son journal de démarrage et les dépendances requises. Évitez de modifier plusieurs paramètres simultanément.
La connexion fonctionne, mais l’accès est refusé. Contrôlez le compte connecté, l’expiration des identifiants et le périmètre autorisé. Une authentification réussie ne donne pas automatiquement accès à chaque dépôt, dossier ou base.
L’assistant n’utilise pas l’outil. Formulez une demande qui nécessite clairement la source connectée et vérifiez les outils exposés dans le client. Distinguez une fonction absente d’un mauvais choix du modèle.
Le résultat semble incomplet. Examinez les filtres, les limites de réponse et la pagination éventuelle. Demandez des références vérifiables plutôt qu’une synthèse seule. Pour une action, contrôlez directement le changement dans l’application concernée.
Avant de conserver la connexion :
- La provenance du serveur et sa documentation sont identifiées.
- Une tâche utile justifie son installation.
- Les permissions correspondent au périmètre prévu.
- Un essai autorisé et un refus hors périmètre ont été vérifiés.
- Les coûts et quotas applicables sont connus.
- La désactivation et la révocation des accès sont documentées.
Gardez uniquement les connexions qui répondent à un besoin régulier. Pour débuter, un serveur bien compris, avec un résultat contrôlable et des droits limités, constitue une base plus facile à entretenir qu’une collection d’intégrations activées sans objectif précis.
Questions fréquentes
Faut-il un serveur physique pour utiliser MCP ?
Non. Le mot serveur désigne ici un programme qui répond à une application cliente. Il peut démarrer sur votre ordinateur ou être hébergé par un fournisseur accessible par le réseau.
Peut-on utiliser un serveur MCP sans savoir coder ?
Oui, si votre assistant propose un formulaire de connexion ou une installation guidée. Vous devez toutefois comprendre les autorisations demandées et savoir révoquer l'accès. Certaines installations locales nécessitent davantage de connaissances techniques.
Un serveur MCP fonctionne-t-il avec tous les modèles ?
La connexion dépend d'abord de l'application qui héberge le modèle et de sa prise en charge de MCP. La capacité du modèle à choisir correctement un outil reste une question distincte. Un serveur compatible ne garantit donc pas une exécution fiable de vos demandes.
Peut-on connecter plusieurs serveurs MCP en même temps ?
Oui, lorsque l'application le permet. Activez seulement ceux qui servent à la tâche en cours : des fonctions qui se recouvrent peuvent compliquer le choix des outils. Vérifiez aussi les possibilités de transfert de données entre services.